Un'indagine sulla soddisfazione dei pazienti raccoglie migliaia di questionari. Sembra un campione enorme, ma i questionari sono stati lasciati in sala d'attesa e compilati da chi aveva voglia di farlo. La numerosità non compensa un campione scelto male: se il modo di selezionare le persone è distorto, anche un campione grande dà risposte sbagliate.
Perché si campiona
Raramente si possono osservare tutti: tutti i pazienti di una regione, tutte le cartelle di un anno, tutte le prescrizioni. Si osserva allora una parte, il campione, e da quella si traggono conclusioni sul tutto, la popolazione. Funziona come assaggiare un cucchiaio di minestra per sapere se è salata: basta un cucchiaio, a patto di aver mescolato bene. Il campionamento è il modo di "mescolare" prima di assaggiare.
Campioni probabilistici
Sono quelli in cui ogni unità della popolazione ha una probabilità nota, e non nulla, di essere scelta. Solo così si può calcolare quanto le stime sono precise.
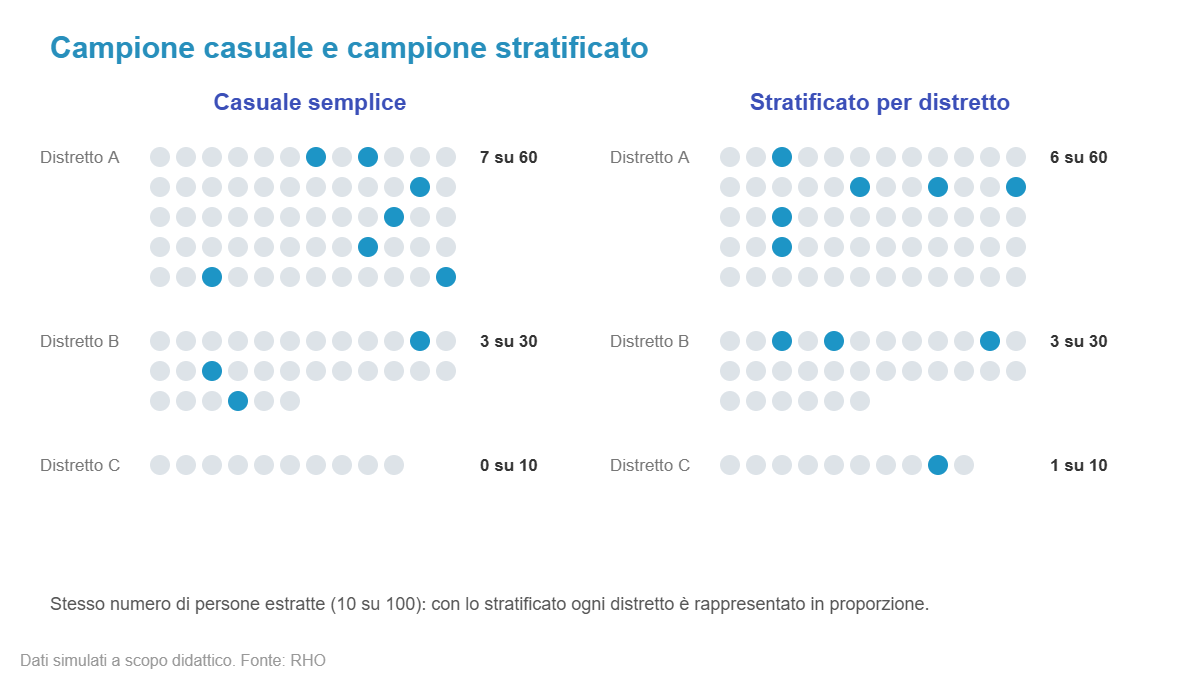
- Casuale semplice: ogni unità ha la stessa probabilità di essere scelta. È il riferimento teorico, ma richiede una lista completa della popolazione.
- Stratificato: la popolazione si divide in gruppi (per esempio per distretto o fascia d'età) e si estrae da ciascuno. Garantisce la presenza di tutti i gruppi e migliora la precisione.
- A grappoli: si estraggono gruppi interi, come reparti o scuole. È più pratico e meno costoso, ma meno efficiente, e l'analisi deve tenerne conto.
- Sistematico: si sceglie un'unità ogni k, per esempio una cartella ogni dieci. È semplice, a patto che l'elenco non abbia una periodicità nascosta.
Quanti soggetti servono
La numerosità si calcola prima di iniziare e dipende da tre cose: la precisione desiderata (o la differenza che si vuole essere in grado di rilevare), la variabilità del fenomeno e il livello di errore che si accetta. Un campione troppo piccolo rischia di non trovare effetti reali. Un campione inutilmente grande spreca risorse e, negli studi clinici, espone al rischio più persone del necessario.
Gli errori più comuni
Usare campioni di convenienza e poi generalizzare i risultati a tutta la popolazione. Ignorare i non rispondenti, che raramente sono simili ai rispondenti. Analizzare un campione a grappoli come se fosse casuale semplice, sottostimando l'incertezza.
Un esempio in sanità
Per stimare la qualità della codifica delle schede di dimissione in una regione, non serve controllare tutte le cartelle. Un campione stratificato per struttura e tipo di ricovero, con una numerosità calcolata in anticipo, dà una stima affidabile con una frazione del lavoro, e consente anche di dire quanto la stima è precisa.
Stimatori e numerosità
Campionamento casuale semplice
Estraendo \(n\) unità senza ripetizione da una popolazione di \(N\), la media campionaria \(\bar y\) è uno stimatore non distorto della media della popolazione, con varianza
$$\mathrm{Var}(\bar y) = \left(1 - \frac{n}{N}\right)\frac{S^2}{n}$$Il termine \(1 - n/N\) è la correzione per popolazione finita: diventa trascurabile quando si campiona meno del 5% circa della popolazione.
Campionamento stratificato
Con \(H\) strati di peso \(W_h = N_h/N\), lo stimatore combina le medie di strato:
$$\bar y_{st} = \sum_{h=1}^{H} W_h\,\bar y_h, \qquad \mathrm{Var}(\bar y_{st}) = \sum_{h=1}^{H} W_h^2 \left(1 - \frac{n_h}{N_h}\right)\frac{S_h^2}{n_h}$$La varianza dipende solo dalla variabilità dentro gli strati: se gli strati sono internamente omogenei, lo stratificato è molto più preciso del casuale semplice. Con l'allocazione proporzionale \(n_h = n\,W_h\) non è mai meno preciso; l'allocazione di Neyman, \(n_h \propto N_h S_h\), assegna più unità agli strati più variabili.
Numerosità per stimare una proporzione
Per stimare una proporzione attesa \(p\) con un margine d'errore \(e\) al livello di confidenza \(1-\alpha\):
$$n_0 = \frac{z_{1-\alpha/2}^2\; p(1-p)}{e^2}, \qquad n = \frac{n_0}{1 + (n_0 - 1)/N}$$Se \(p\) è ignota, \(p = 0{,}5\) dà il valore più prudente. Nel campionamento a grappoli la numerosità va moltiplicata per il design effect \(1 + (m-1)\rho\), come nei disegni a cluster.
Numerosità e campione stratificato in R
# Numerosità per stimare una proporzione (attesa 20%) con margine ±3%
p <- 0.20; e <- 0.03
n <- ceiling(qnorm(0.975)^2 * p * (1 - p) / e^2)
n

# Correzione per popolazione finita (N = 5.000 cartelle)
N <- 5000
ceiling(n / (1 + (n - 1) / N))

# Campione stratificato proporzionale (10%) per distretto
set.seed(55)
pop <- data.frame(id = 1:1000,
                  distretto = rep(c("A", "B", "C"), c(600, 300, 100)))
camp <- do.call(rbind, lapply(split(pop, pop$distretto),
                function(s) s[sample(nrow(s), round(nrow(s) * 0.10)), ]))
table(camp$distretto)
Come leggere l'output
Per stimare una quota di errori di codifica attesa del 20% con un margine di ±3 punti percentuali servono 683 cartelle. Se le cartelle dell'anno sono 5.000, la correzione per popolazione finita riduce il campione a 602.
Il campione stratificato estrae esattamente il 10% da ogni distretto: 60, 30 e 10 unità. Per analisi più complesse, con pesi, strati e grappoli, il riferimento in R è il pacchetto survey, che calcola stime ed errori standard coerenti con il disegno.
Vedi anche