"p = 0,04, quindi il trattamento funziona". "p = 0,06, quindi non c'è differenza". Sono tra le frasi più comuni nella letteratura clinica, e sono entrambe letture sbagliate. Nel 2016 l'American Statistical Association ha sentito il bisogno di pubblicare una dichiarazione ufficiale per chiarire come interpretare il valore p.
L'idea, in parole semplici
La verifica di ipotesi ragiona come un processo. Si parte dalla presunzione di innocenza: il trattamento non ha effetto. Poi si guardano le prove, cioè i dati. Se le prove sono molto difficili da spiegare con l'innocenza, la si rifiuta. Se non lo sono, non si è dimostrata l'innocenza: semplicemente le prove non bastano per condannare. È la stessa differenza che c'è tra "assolto" e "innocente".
Il ragionamento
Si parte da un'ipotesi nulla, di solito "non c'è differenza" o "non c'è effetto". Ci si chiede poi quanto sarebbe probabile osservare dati come quelli raccolti, o ancora più estremi, se l'ipotesi nulla fosse vera. Quella probabilità è il valore p. Se è piccola, i dati sono poco compatibili con l'ipotesi nulla.
Cosa il valore p non dice
- Non è la probabilità che l'ipotesi nulla sia vera.
- Non misura quanto è grande l'effetto né quanto è importante dal punto di vista clinico.
- La soglia di 0,05 è una convenzione: 0,049 e 0,051 portano quasi la stessa informazione.
- Un risultato non significativo non dimostra l'assenza di effetto: può voler dire che il campione era troppo piccolo.
I due errori possibili
L'errore di primo tipo è dichiarare un effetto che non esiste: un falso positivo. L'errore di secondo tipo è non vedere un effetto che esiste: un falso negativo. La potenza di uno studio è la probabilità di evitare il secondo, e dipende soprattutto dalla numerosità del campione.
Gli errori più comuni
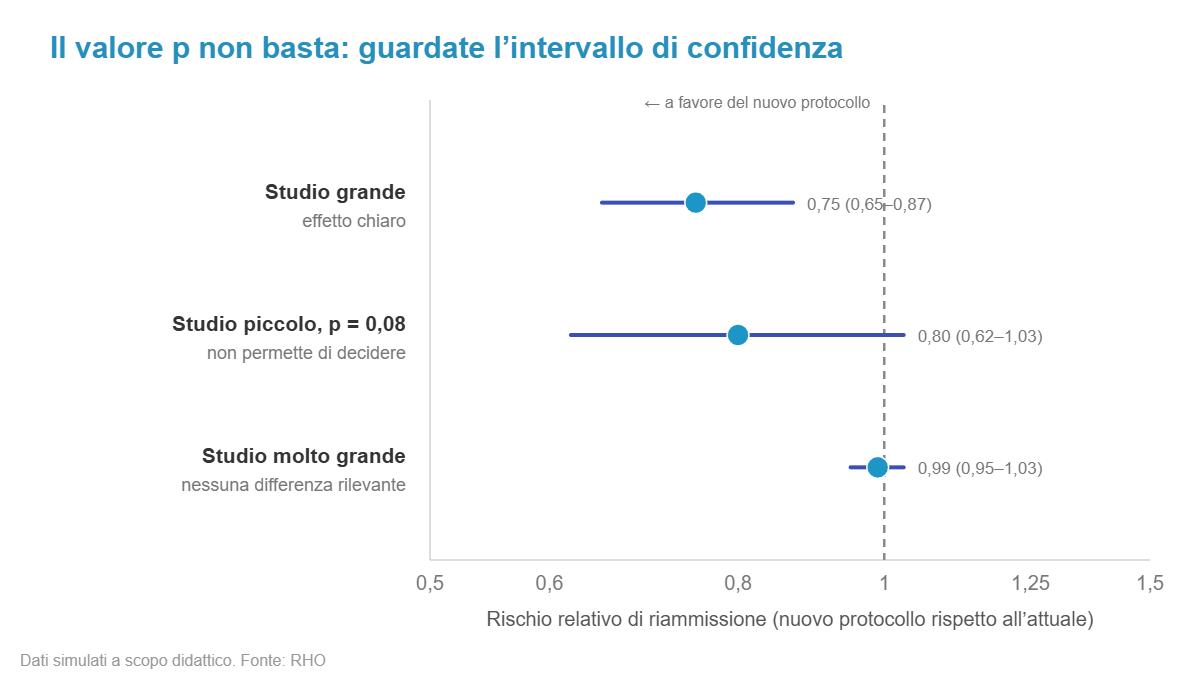
Fare molti test e riportare solo quelli significativi: con venti confronti indipendenti è facile che almeno uno risulti significativo per puro caso. Presentare il valore p senza la stima dell'effetto. Il modo più informativo di riportare un risultato resta la stima con il suo intervallo di confidenza, che mostra insieme la dimensione dell'effetto e l'incertezza.
Un esempio in sanità
Un confronto tra due protocolli di dimissione mostra una riduzione delle riammissioni con p = 0,08. Invece di concludere "nessuna differenza", conviene guardare l'intervallo di confidenza: se va da una riduzione importante a un lieve aumento, la conclusione corretta è che lo studio non è in grado di decidere, e servono più dati.
Statistica test, valore p, potenza
Una statistica test \(T\) riassume la distanza tra i dati e l'ipotesi nulla \(H_0\). Osservato il valore \(t_{oss}\), il valore p bilaterale è
$$p = P_{H_0}\big(|T| \ge |t_{oss}|\big)$$cioè una probabilità calcolata assumendo vera \(H_0\). Per confrontare due proporzioni, per esempio, si usa
$$z = \frac{\hat p_1 - \hat p_2}{\sqrt{\bar p(1-\bar p)\left(\frac{1}{n_1} + \frac{1}{n_2}\right)}}$$che sotto \(H_0\) segue approssimativamente una normale standard.
Errori e potenza
$$\alpha = P(\text{rifiutare } H_0 \mid H_0 \text{ vera}), \qquad \beta = P(\text{non rifiutare } H_0 \mid H_1 \text{ vera}), \qquad \text{potenza} = 1 - \beta$$La potenza cresce con la numerosità e con la dimensione dell'effetto, e diminuisce con la variabilità. Uno studio con potenza bassa ha un doppio problema: spesso non trova effetti reali e, quando li trova, tende a sovrastimarli.
Intervalli di confidenza e test
Un intervallo di confidenza al 95% contiene tutti i valori del parametro che un test al 5% non rifiuterebbe. Per una differenza tra proporzioni:
$$(\hat p_1 - \hat p_2) \pm z_{1-\alpha/2}\sqrt{\frac{\hat p_1(1-\hat p_1)}{n_1} + \frac{\hat p_2(1-\hat p_2)}{n_2}}$$Confronti multipli
Con \(m\) test indipendenti a livello \(\alpha\), la probabilità di almeno un falso positivo è \(1 - (1-\alpha)^m\): con 20 test e \(\alpha = 0{,}05\) è circa il 64%. La correzione di Bonferroni usa \(\alpha/m\) per ogni test; il metodo di Holm, che ordina i valori p e applica soglie progressive, controlla lo stesso errore con più potenza. Quando i test sono molti, come in genomica, si controlla invece la quota attesa di falsi positivi (false discovery rate, Benjamini-Hochberg).
Test, potenza e correzioni in R
# Riammissioni: 45 su 400 con il nuovo protocollo, 60 su 400 con l'attuale
prop.test(x = c(45, 60), n = c(400, 400), correct = FALSE)

# Potenza dello studio e numerosità necessaria
power.prop.test(n = 400, p1 = 0.15, p2 = 0.1125)
power.prop.test(p1 = 0.15, p2 = 0.1125, power = 0.80)

# Correzione per confronti multipli
p <- c(0.004, 0.012, 0.030, 0.045, 0.210)
round(p.adjust(p, method = "holm"), 3)
Come leggere l'output
Le riammissioni passano dal 15,0% all'11,25%, ma il test dà p = 0,12. L'intervallo di confidenza della differenza va da −8,4 a +0,9 punti percentuali: compatibile sia con una riduzione importante sia con un piccolo aumento.
Il calcolo della potenza spiega perché: con 400 pazienti per gruppo lo studio aveva solo il 35% di probabilità di rilevare una differenza di questa entità. Per arrivare all'80% ne sarebbero serviti circa 1.272 per gruppo. Non è un risultato "negativo": è uno studio troppo piccolo per rispondere.
Con la correzione di Holm, dei cinque valori p originali solo i primi due restano sotto 0,05 (0,020 e 0,048).
Vedi anche
Test Chi-quadro · Confronti tra medie · Disegno sperimentale