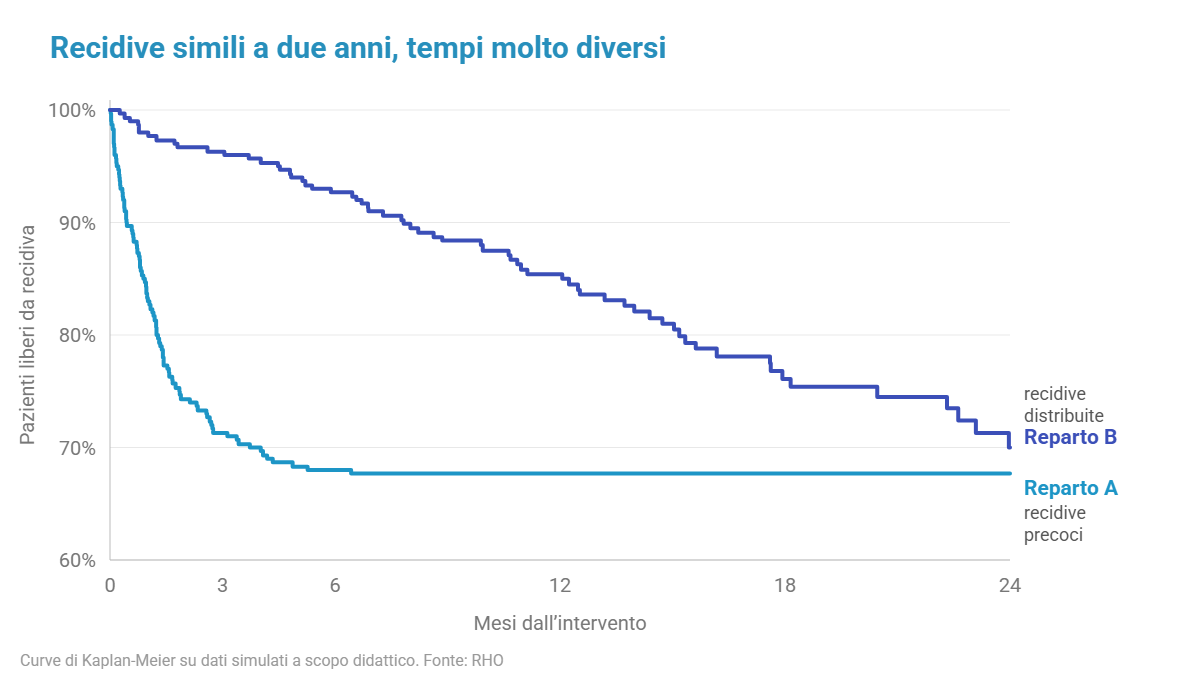
Due reparti trattano pazienti simili. Alla fine dello studio, in entrambi circa il 30% dei pazienti ha avuto una recidiva. Sembrano uguali. Ma in uno le recidive arrivano quasi tutte nei primi tre mesi, nell'altro si distribuiscono in due anni. Per il paziente, e per chi organizza il follow-up, sono due storie molto diverse.
L'analisi di sopravvivenza serve a questo: studiare non solo se un evento accade, ma quando. Il nome viene dagli studi sulla mortalità, ma l'evento può essere qualsiasi cosa che accade una volta sola e in un momento preciso: una riammissione, una recidiva, la dimissione, la sospensione di una terapia, il ritorno al lavoro.
Perché non basta contare gli eventi
La tentazione è semplice: si contano i pazienti che hanno avuto l'evento e si divide per il totale. Il problema è che i pazienti non vengono seguiti tutti per lo stesso tempo. Chi è entrato nello studio a gennaio è stato osservato per due anni, chi è entrato a novembre per poche settimane. Mettere tutti nello stesso calcolo significa confrontare storie di lunghezza diversa.
Il problema dei dati incompleti
In quasi ogni studio alcuni pazienti escono dall'osservazione prima che l'evento accada: lo studio finisce, si trasferiscono, smettono di presentarsi ai controlli. Si chiamano osservazioni censurate. Di loro non sappiamo tutto, però sappiamo qualcosa di prezioso: fino a quel giorno l'evento non si era verificato.
Un'analogia aiuta. Immaginate di voler stimare quanto dura una lampadina, e di dover chiudere l'esperimento dopo un anno quando alcune lampadine sono ancora accese. Buttarle via dal calcolo farebbe sembrare le lampadine meno durevoli di quanto sono. Contarle come "guaste a un anno" sarebbe sbagliato allo stesso modo. L'informazione corretta è: "durano almeno un anno".
Escludere i pazienti censurati, o trattarli come se l'evento non fosse mai avvenuto, porta quindi a stime distorte. L'analisi di sopravvivenza usa quell'informazione parziale nel modo corretto.
Gli strumenti principali
- La curva di Kaplan-Meier mostra, giorno per giorno, la quota di pazienti ancora liberi dall'evento. Scende a gradini: ogni gradino è un evento. È il grafico che si trova in quasi ogni studio clinico.
- Il log-rank test verifica se le curve di due o più gruppi sono diverse più di quanto ci si aspetterebbe per caso.
- Il modello di Cox stima l'effetto di più fattori insieme (età, comorbidità, tipo di intervento) e restituisce gli hazard ratio: un hazard ratio di 2 indica che, in ogni momento, il rischio di evento è doppio.
Gli errori più comuni
Il modello di Cox presuppone che l'effetto di un fattore resti costante nel tempo (ipotesi di rischi proporzionali). Va verificata, non data per scontata.
Quando esistono eventi concorrenti, per esempio il decesso che impedisce di osservare una riammissione, la curva di Kaplan-Meier sovrastima il rischio e servono metodi specifici.
Infine c'è il tempo immortale: se si classifica un paziente in base a qualcosa che accade dopo l'inizio del follow-up, come una terapia iniziata a distanza di settimane, si regala al gruppo trattato un periodo in cui per costruzione non poteva avere l'evento.
Un esempio in sanità
Con i dati delle schede di dimissione ospedaliera si può stimare, per ciascuna struttura, il tempo alla riammissione dopo un intervento, tenendo conto dei pazienti deceduti e di quelli seguiti per periodi diversi. È un'analisi che richiede scelte da dichiarare: quale evento, da quale momento far partire il tempo, come trattare i decessi.
Le formule essenziali
Funzione di sopravvivenza e hazard
Sia \(T\) il tempo all'evento. La funzione di sopravvivenza è la probabilità di non aver ancora avuto l'evento al tempo \(t\):
$$S(t) = P(T > t)$$La funzione di rischio (hazard) è il tasso istantaneo di evento al tempo \(t\), per chi è ancora a rischio in quel momento:
$$h(t) = \lim_{\Delta t \to 0} \frac{P(t \le T < t + \Delta t \mid T \ge t)}{\Delta t}$$Le due funzioni sono legate da \(S(t) = \exp\!\left(-\int_0^t h(u)\,du\right)\): conoscere l'una equivale a conoscere l'altra.
Lo stimatore di Kaplan-Meier
Ordinati i tempi distinti in cui si osserva almeno un evento, \(t_1 < t_2 < \dots\), con \(d_i\) eventi e \(n_i\) soggetti ancora a rischio in \(t_i\):
$$\hat S(t) = \prod_{i:\, t_i \le t} \left(1 - \frac{d_i}{n_i}\right)$$I soggetti censurati contribuiscono al denominatore \(n_i\) finché restano in osservazione, poi escono. È così che l'informazione parziale viene usata senza distorsioni, a patto che la censura sia non informativa: chi esce dallo studio deve avere lo stesso rischio di chi resta. La varianza si stima con la formula di Greenwood:
$$\widehat{\mathrm{Var}}\big[\hat S(t)\big] = \hat S(t)^2 \sum_{i:\, t_i \le t} \frac{d_i}{n_i\,(n_i - d_i)}$$Il log-rank test
In ogni tempo di evento si confronta il numero di eventi osservati nel gruppo 1 con quello atteso se i due gruppi avessero lo stesso rischio, \(E_{1i} = d_i\, n_{1i}/n_i\). Sommando su tutti i tempi:
$$\chi^2_{LR} = \frac{\left(\sum_i d_{1i} - \sum_i E_{1i}\right)^2}{\sum_i V_i}, \qquad V_i = \frac{n_{1i}\, n_{2i}\, d_i\,(n_i - d_i)}{n_i^2\,(n_i - 1)}$$Sotto l'ipotesi nulla la statistica segue approssimativamente una distribuzione \(\chi^2\) con 1 grado di libertà. Il test ha la massima potenza quando gli hazard sono proporzionali e la perde se le curve si incrociano.
Il modello di Cox
Il modello a rischi proporzionali descrive l'hazard di un soggetto con covariate \(\mathbf{x}\) come:
$$h(t \mid \mathbf{x}) = h_0(t)\,\exp(\beta_1 x_1 + \dots + \beta_p x_p)$$Il rischio di base \(h_0(t)\) non viene specificato: per questo il modello è detto semiparametrico. Il rapporto tra gli hazard di due soggetti che differiscono di un'unità in \(x_j\), a parità del resto, è \(HR_j = e^{\beta_j}\) ed è costante nel tempo: proprio questa è l'ipotesi da verificare. I coefficienti si stimano massimizzando la verosimiglianza parziale:
$$L(\boldsymbol\beta) = \prod_{i \,\in\, \text{eventi}} \frac{\exp(\boldsymbol\beta^\top \mathbf{x}_i)}{\sum_{j \in R(t_i)} \exp(\boldsymbol\beta^\top \mathbf{x}_j)}$$dove \(R(t_i)\) è l'insieme dei soggetti a rischio al tempo \(t_i\).
Eventi concorrenti
Se un evento concorrente (per esempio il decesso) impedisce l'evento di interesse, \(1 - \hat S(t)\) calcolato censurando i decessi non stima più la probabilità dell'evento: la sovrastima. La quantità corretta è l'incidenza cumulativa, \(F_k(t) = P(T \le t,\ \text{causa} = k)\), stimata con il metodo di Aalen-Johansen. Per modellarla in funzione delle covariate si usa il modello di Fine e Gray.
L'analisi in poche righe
L'esempio usa lung, un dataset pubblico sul tumore del polmone incluso nel pacchetto survival: 228 pazienti, tempo in giorni, status uguale a 2 per i decessi e a 1 per le osservazioni censurate.
library(survival)
data(cancer, package = "survival")

# Curve di Kaplan-Meier per sesso (1 = uomini, 2 = donne)
km <- survfit(Surv(time, status) ~ sex, data = lung)
summary(km, times = c(180, 365))
plot(km, col = c("#1D95C6", "#3B4FB8"), lwd = 2,
     xlab = "Giorni", ylab = "Sopravvivenza")

# Log-rank test
survdiff(Surv(time, status) ~ sex, data = lung)

# Modello di Cox e verifica dei rischi proporzionali
cox <- coxph(Surv(time, status) ~ sex + age + ph.ecog, data = lung)
summary(cox)
cox.zph(cox)
Come leggere l'output
A un anno la sopravvivenza stimata è del 34% negli uomini e del 53% nelle donne. Il log-rank test dà \(\chi^2 = 10{,}3\) con 1 grado di libertà (p = 0,001).
Nel modello di Cox il coefficiente di sex è −0,55, cioè \(HR = e^{-0{,}55} = 0{,}58\) (IC 95%: 0,41–0,80): a parità di età e di stato funzionale (ph.ecog), le donne hanno un rischio istantaneo di decesso inferiore di circa il 42%. Ogni punto in più sulla scala ECOG moltiplica il rischio per 1,59.
cox.zph() verifica l'ipotesi di rischi proporzionali sui residui di Schoenfeld. Qui nessun test è significativo (globale p = 0,22), quindi i dati non mostrano violazioni evidenti. Conviene comunque guardare anche il grafico, con plot(cox.zph(cox)).
Per gli eventi concorrenti, survfit() accetta uno stato con più di due modalità (un factor) e stima direttamente le incidenze cumulative. Il modello di Fine e Gray si ottiene con finegray() dello stesso pacchetto, oppure con il pacchetto cmprsk.