I pazienti di un ospedale hanno degenze più lunghe. Dipende dall'organizzazione, o dal fatto che sono più anziani e più complessi? Per rispondere bisogna considerare più fattori insieme. La regressione lineare è lo strumento di base per farlo quando il risultato è una variabile continua.
L'idea, in parole semplici
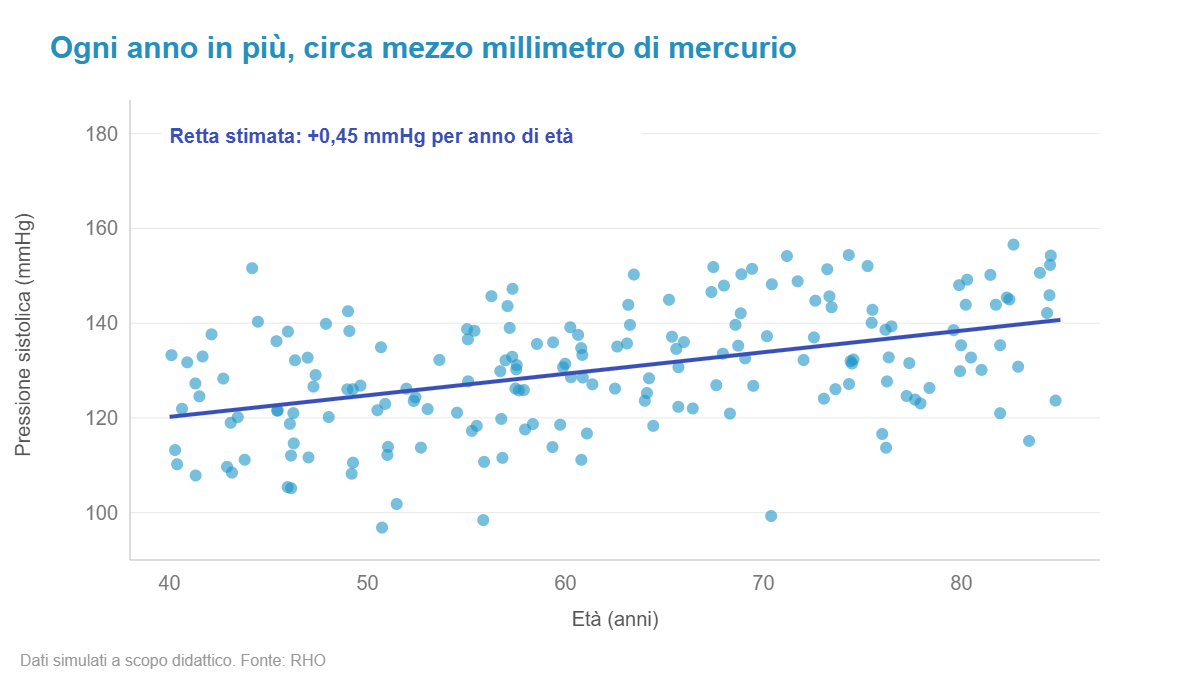
Nel caso più semplice la regressione traccia, in mezzo a una nuvola di punti, la retta che passa "più vicina possibile" a tutti. La pendenza della retta dice di quanto cambia in media il risultato quando il fattore aumenta di un'unità: per esempio, di quanti mmHg sale la pressione per ogni anno di età. Il vero vantaggio arriva con più fattori: la regressione stima l'effetto di ciascuno tenendo fermi gli altri, qualcosa che nessun grafico a due dimensioni riesce a mostrare.
Cosa stima il modello
Il modello stima quanto cambia in media il risultato per ogni unità in più di un fattore, a parità degli altri fattori inclusi. Un coefficiente di 0,5 sull'età, in un modello per la pressione sistolica, significa che per ogni anno in più la pressione è in media più alta di mezzo millimetro di mercurio, a parità di sesso, peso e delle altre variabili nel modello.
Le condizioni da verificare
- Linearità: la relazione tra fattore e risultato è approssimativamente una retta. Se non lo è, si possono usare trasformazioni o funzioni più flessibili.
- Indipendenza: le osservazioni non sono raggruppate. Pazienti dello stesso ospedale o misure ripetute sulla stessa persona richiedono modelli multilivello.
- Varianza costante e normalità dei residui: si controllano sui residui del modello, non sulla variabile di partenza.
Queste condizioni si verificano soprattutto guardando i grafici dei residui, più che con test formali.
Gli errori più comuni
Interpretare un coefficiente come effetto causale: la regressione aggiusta solo per i fattori inclusi, non per quelli che non sono stati misurati. Valutare il modello solo dall'R², che dice quanta variabilità viene spiegata ma non se il modello è corretto. Includere variabili molto correlate tra loro, che rendono instabili i coefficienti. Usare il modello per fare previsioni fuori dall'intervallo dei dati osservati.
Un esempio in sanità
Per confrontare la durata della degenza tra strutture, un modello di regressione aggiustato per età, sesso, comorbidità e tipo di ricovero dà un confronto molto più equo delle medie grezze. Il modello va però adattato ai dati: la degenza è asimmetrica e i pazienti sono raggruppati per struttura. Spesso servono una trasformazione logaritmica o un modello lineare generalizzato.
Il modello e la stima
Per \(n\) osservazioni e \(p\) fattori, il modello è
$$y_i = \beta_0 + \beta_1 x_{i1} + \dots + \beta_p x_{ip} + \varepsilon_i, \qquad \varepsilon_i \sim N(0, \sigma^2) \text{ indipendenti}$$o, in forma matriciale, \(\mathbf{y} = \mathbf{X}\boldsymbol\beta + \boldsymbol\varepsilon\). Il metodo dei minimi quadrati sceglie i coefficienti che minimizzano la somma dei quadrati dei residui, \(\sum_i (y_i - \hat y_i)^2\), e ha soluzione
$$\hat{\boldsymbol\beta} = (\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{y}, \qquad \widehat{\mathrm{Var}}(\hat{\boldsymbol\beta}) = \hat\sigma^2 (\mathbf{X}^\top\mathbf{X})^{-1}, \qquad \hat\sigma^2 = \frac{\sum_i e_i^2}{n - p - 1}$$Nel caso di un solo fattore la pendenza è \(\hat\beta_1 = \sum (x_i - \bar x)(y_i - \bar y) / \sum (x_i - \bar x)^2\).
Inferenza sui coefficienti
Ogni coefficiente si confronta con zero tramite \(t = \hat\beta_j / SE(\hat\beta_j)\), con \(n - p - 1\) gradi di libertà; l'intervallo di confidenza è \(\hat\beta_j \pm t_{0{,}975}\, SE(\hat\beta_j)\).
R² e R² corretto
$$R^2 = 1 - \frac{\sum_i (y_i - \hat y_i)^2}{\sum_i (y_i - \bar y)^2}, \qquad R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}$$\(R^2\) aumenta sempre aggiungendo variabili; quello corretto penalizza i fattori inutili. Un \(R^2\) basso non rende il modello sbagliato: in clinica i singoli esiti sono molto variabili anche quando gli effetti medi sono stimati con precisione.
Collinearità
Il fattore di inflazione della varianza \(VIF_j = 1/(1 - R_j^2)\), dove \(R_j^2\) è l'\(R^2\) della regressione di \(x_j\) sugli altri fattori, misura quanto la varianza di \(\hat\beta_j\) è gonfiata dalla correlazione con gli altri fattori. Valori sopra 5-10 sono un segnale d'allarme.
La regressione in R
set.seed(100)
eta   <- 40 + runif(180) * 45
sesso <- factor(sample(c("F", "M"), 180, replace = TRUE))
pas   <- 100 + 0.5 * eta + 4 * (sesso == "M") + rnorm(180, 0, 11)

fit <- lm(pas ~ eta + sesso)
summary(fit)
confint(fit)

# Diagnostica: residui contro valori stimati e grafico dei quantili
par(mfrow = c(1, 2)); plot(fit, which = 1:2)
Come leggere l'output
Il coefficiente dell'età è 0,48 mmHg per anno (IC 95%: 0,35–0,61), vicino al valore 0,5 usato per simulare i dati. Gli uomini hanno in media una pressione più alta di 4,6 mmHg a parità di età (IC 95%: 1,3–7,9).
L'\(R^2\) è 0,26: età e sesso spiegano circa un quarto della variabilità della pressione. Il resto è variabilità individuale, con una deviazione standard residua di 11,3 mmHg. I due grafici diagnostici servono a verificare che i residui non abbiano andamenti sistematici e siano approssimativamente normali.