Media e deviazione standard funzionano bene quando i dati si distribuiscono in modo simmetrico attorno a un centro. In sanità succede meno spesso di quanto si pensi: costi, degenze, tempi di attesa, consumi di farmaci hanno quasi sempre una forma sbilanciata. Simmetria e curtosi descrivono proprio questa forma.
La forma dei dati, in parole semplici
Immaginate l'istogramma di una variabile come il profilo di una collina. Se i due versanti sono uguali, la distribuzione è simmetrica: media e mediana coincidono al centro. Se un versante scende dolcemente e l'altro si allunga in una coda, la distribuzione è asimmetrica. La curtosi guarda invece alle code: dice se i valori molto lontani dal centro sono più frequenti di quanto ci si aspetterebbe in una distribuzione "normale", la classica curva a campana.
Asimmetria
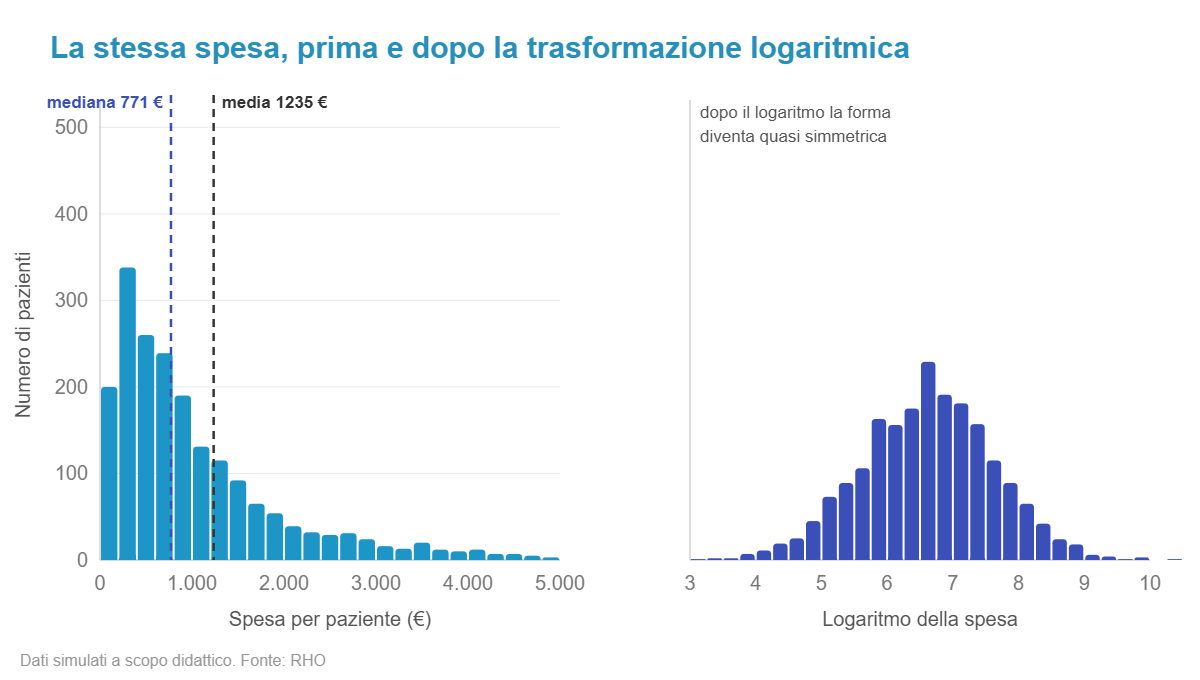
Una distribuzione è asimmetrica positiva quando ha una coda lunga verso destra: molti valori bassi e pochi valori molto alti. È il caso dei costi di ricovero, dove pochi pazienti complessi pesano moltissimo. In questa situazione la media supera la mediana e descrive male il paziente tipico.
L'asimmetria negativa ha la coda a sinistra: per esempio l'età dei pazienti in un reparto geriatrico, concentrata sui valori alti con pochi pazienti più giovani.
Curtosi
La curtosi descrive quanto pesano le code rispetto a una distribuzione normale. Una curtosi elevata segnala valori estremi più frequenti del previsto. Per convenzione la distribuzione normale ha curtosi pari a 3, e molti software riportano la "curtosi in eccesso", cioè la differenza da 3. Conviene controllare quale delle due versioni si sta leggendo.
A cosa servono in pratica
- Scegliere l'indice riassuntivo: con forte asimmetria, mediana e quartili invece di media e deviazione standard.
- Valutare se servono trasformazioni, per esempio il logaritmo, che spesso rende simmetrici costi e concentrazioni.
- Orientare la scelta tra test parametrici e non parametrici, o verso modelli pensati per dati asimmetrici.
Gli errori più comuni
Affidarsi solo al valore numerico degli indici: con pochi dati sono instabili, con molti dati anche scostamenti irrilevanti risultano "significativi" nei test di normalità. Un istogramma o un grafico dei quantili (Q-Q plot) vanno sempre guardati insieme ai numeri. Ricordare anche che nei modelli di regressione conta la forma dei residui, non quella della variabile di partenza.
Un esempio in sanità
Nell'analisi della spesa farmaceutica per paziente, una piccola quota di pazienti con terapie ad alto costo può determinare gran parte della spesa totale. Riportare solo la spesa media fa sembrare il problema diffuso, quando è concentrato. Descrivere la forma della distribuzione aiuta a dirigere l'attenzione dove serve.
Momenti e indici di forma
Indicato con \(m_k = \frac{1}{n}\sum_{i=1}^n (x_i - \bar x)^k\) il momento centrale campionario di ordine \(k\), i due indici più usati sono:
$$g_1 = \frac{m_3}{m_2^{3/2}}, \qquad g_2 = \frac{m_4}{m_2^{2}} - 3$$\(g_1\) è l'asimmetria: nulla per distribuzioni simmetriche, positiva con coda a destra. \(g_2\) è la curtosi in eccesso: nulla per la normale, positiva per code più pesanti (distribuzione leptocurtica), negativa per code più leggere (platicurtica). I software applicano spesso piccole correzioni per la numerosità, per esempio \(G_1 = g_1\sqrt{n(n-1)}/(n-2)\): con campioni grandi la differenza è trascurabile.
Indici robusti
Poiché i momenti di ordine 3 e 4 sono dominati dai valori estremi, esistono alternative basate sui quantili, come l'indice di Bowley:
$$B = \frac{(Q_3 - \mathrm{Me}) - (\mathrm{Me} - Q_1)}{Q_3 - Q_1}$$compreso tra −1 e 1 e poco sensibile a pochi valori anomali.
Perché il logaritmo funziona
Molte grandezze sanitarie nascono da effetti che si moltiplicano più che sommarsi (un costo = giorni × intensità × tariffa). Se \(\log X\) è approssimativamente normale con media \(\mu\) e varianza \(\sigma^2\), \(X\) segue una distribuzione lognormale con
$$\mathrm{Me}(X) = e^{\mu}, \qquad E(X) = e^{\mu + \sigma^2/2}$$La media supera sempre la mediana, e tanto di più quanto più grande è \(\sigma\). Attenzione alla ritrasformazione: la media dei logaritmi, riportata in scala originale con l'esponenziale, stima la mediana (la media geometrica), non la media. Per stimare la spesa media serve un fattore di correzione, come lo smearing estimator di Duan.
Asimmetria e curtosi in R
set.seed(33)
spesa <- exp(rnorm(2000, 6.6, 1.0))

asimmetria  <- function(x) { m <- x - mean(x); mean(m^3) / mean(m^2)^1.5 }
curtosi_ecc <- function(x) { m <- x - mean(x); mean(m^4) / mean(m^2)^2 - 3 }

c(media = mean(spesa), mediana = median(spesa))
c(asimmetria = asimmetria(spesa), curtosi = curtosi_ecc(spesa))
c(asimmetria = asimmetria(log(spesa)), curtosi = curtosi_ecc(log(spesa)))

qqnorm(log(spesa)); qqline(log(spesa), col = "#1D95C6", lwd = 2)
Come leggere l'output
La spesa media è di 1.232 euro, la mediana di 745: la media è più alta di due terzi. L'asimmetria vale 5,1 e la curtosi in eccesso 42,8, valori tipici di una distribuzione con una coda molto lunga.
Dopo il logaritmo entrambi gli indici scendono quasi a zero (0,01 e 0,04) e il Q-Q plot mostra punti allineati sulla retta: in scala logaritmica la spesa è quasi normale. Le funzioni sono scritte a mano per mostrare le formule; in alternativa, i pacchetti moments ed e1071 offrono skewness() e kurtosis(), con definizioni leggermente diverse tra loro.