R è un linguaggio per l'analisi dei dati e la statistica, nato nel 1993 all'Università di Auckland e oggi sviluppato dall'R Core Team. Si distribuisce con licenza libera. Non si lavora con i menu: si scrivono istruzioni, e l'analisi resta scritta. Questa scheda descrive com'è fatto, da quali pezzi è composto e cosa serve sapere per cominciare.
Come ragiona
R è un linguaggio, non un programma con i menu. Si scrive un'istruzione, si ottiene un risultato. Rispetto a un'interfaccia a finestre sembra un passo indietro, ed è invece quello che permette di rileggere un'analisi come si rilegge un testo: dall'inizio alla fine, vedendo in che ordine sono state prese le decisioni.
Gli elementi
R da solo è il motore. Intorno ci sono alcuni pezzi che si usano quasi sempre, ciascuno con un compito preciso.
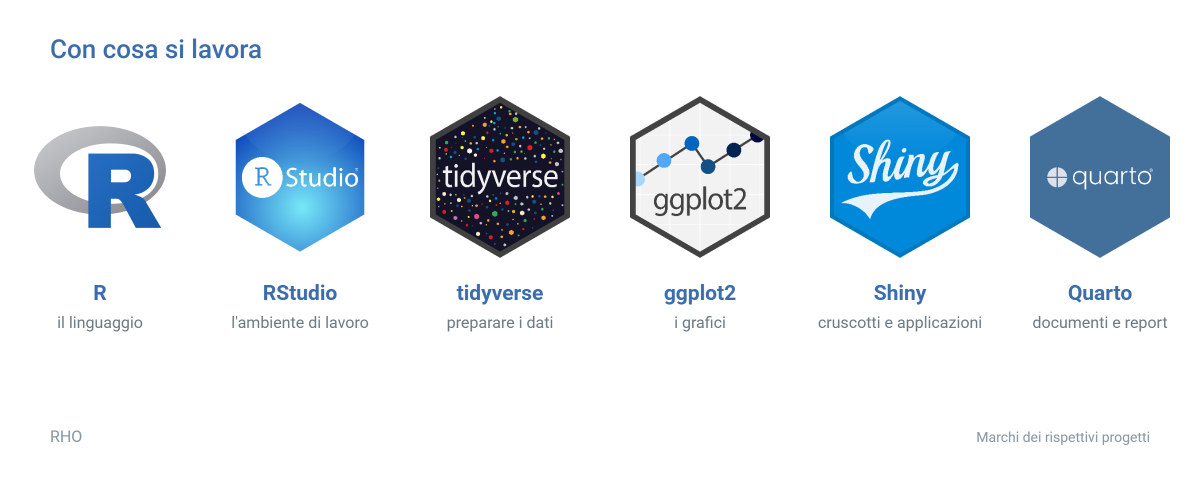
RStudio è l'ambiente di lavoro. Quattro riquadri: l'editor dove si scrive lo script, la console dove le istruzioni vengono eseguite, l'elenco degli oggetti in memoria, e il riquadro che mostra grafici, file e documentazione. Lo distribuisce Posit, ed è gratuito nella versione per computer.
CRAN è l'archivio ufficiale dei pacchetti. Un pacchetto, per restarci, deve superare controlli automatici su più sistemi operativi e documentare ogni funzione; molti portano anche una guida d'uso estesa. Si installa con una istruzione, e la stessa istruzione funziona su qualsiasi macchina.
tidyverse è un insieme di pacchetti che condividono le stesse convenzioni. dplyr per filtrare righe, scegliere colonne, creare variabili e calcolare per gruppo. tidyr per cambiare la forma della tabella, da larga a lunga e viceversa. Le operazioni si concatenano una dopo l'altra, e la sequenza si legge nell'ordine in cui avviene.
ggplot2 costruisce i grafici. Non si sceglie un tipo di grafico da un elenco: si dichiara quale variabile va sull'asse, quale sul colore, quale genera i pannelli, e il grafico si compone di conseguenza. Cambiare un dettaglio è cambiare una riga.
Quarto produce i documenti. Dallo stesso file che contiene l'analisi esce il documento finito, in PDF, Word o pagina web, con tabelle e grafici già dentro. Rifatta l'analisi, il documento si rigenera: non si ricopiano numeri a mano, e non capita che il testo dica una cosa e la tabella un'altra.
Shiny va oltre il documento: si costruisce un cruscotto o una piccola applicazione web, dove chi la usa sceglie il periodo, la struttura o il reparto e vede i risultati aggiornarsi. È la via più breve per mettere un'analisi nelle mani di chi deve decidere senza chiedergli di imparare R.
I pacchetti per la statistica
I metodi arrivano come pacchetti, e spesso li scrive chi quel metodo lo ha proposto. survival per l'analisi di sopravvivenza, con le stime di Kaplan-Meier e il modello di Cox. lme4 per i modelli a effetti misti, quando i dati sono raggruppati per centro o per paziente. metafor per la meta-analisi. mice per l'imputazione multipla dei dati mancanti.
Ogni pacchetto porta con sé il riferimento bibliografico del metodo che implementa, e lo si può chiedere al programma. Quando bisogna motivare una scelta a un revisore o a un committente, lo strumento e l'articolo che lo descrive sono la stessa cosa.
Cosa cambia quando i dati sono quelli veri
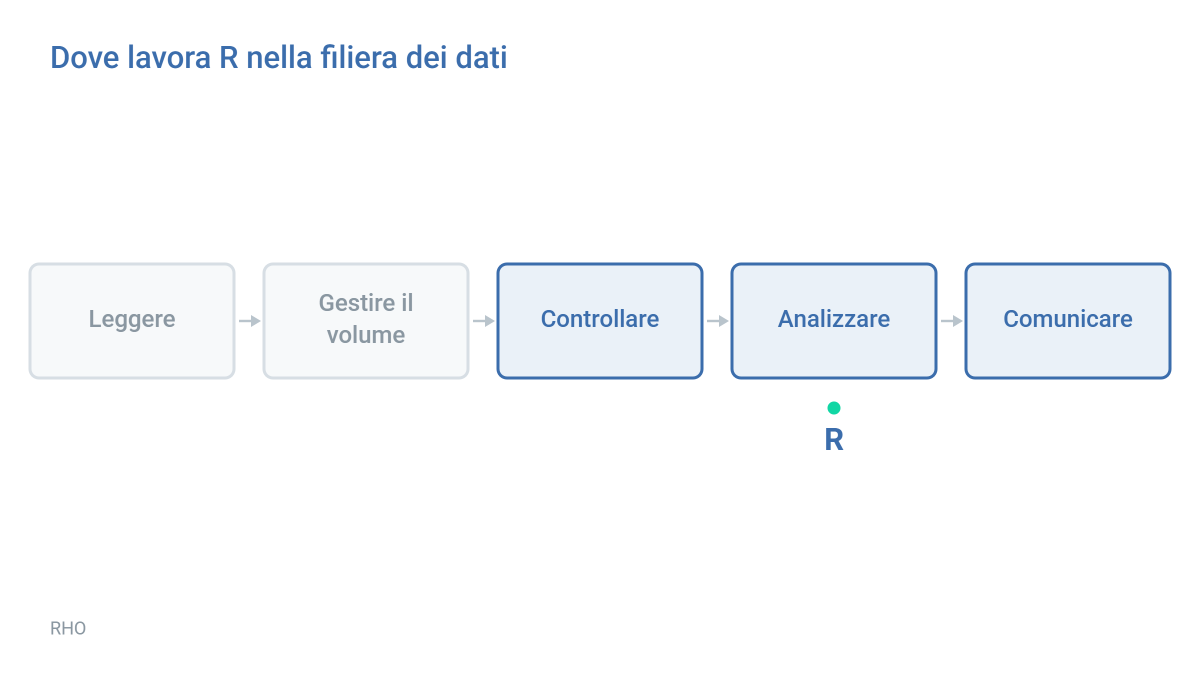
Un questionario da trecento risposte sta ovunque. Un anno di righe di un gestionale, o di schede di dimissione, ci sta a fatica. R tiene i dati in memoria, quindi oltre una certa dimensione il problema smette di essere statistico e diventa di gestione: si interroga il database e si porta dentro R solo quello che serve. È il motivo per cui nella filiera a leggere i dati e a reggerne il volume pensano SQL e DuckDB.
Cosa serve sapere per cominciare
Poco per iniziare, molto per lavorarci. Le cose da capire subito sono cinque:
- come leggere un file e verificare come R ha interpretato le colonne;
- i valori mancanti, che in R sono dichiarati e non spariscono in silenzio;
- le variabili categoriali, che vanno dichiarate se si vuole che i confronti abbiano il riferimento giusto;
- scrivere in uno script invece che nella console;
- lavorare per progetti, così i percorsi dei file non legano il codice a un solo computer.
Chi arriva da SPSS deve disimparare soprattutto una cosa: non esiste il dataset attivo. In R si lavora su oggetti che hanno un nome, e possono essercene molti aperti insieme. È il passaggio che all'inizio disorienta di più, ed è anche quello che poi serve di più.
Dove si scarica
R si prende dal sito del progetto, r-project.org, e i pacchetti da CRAN. RStudio si scarica dal sito di Posit. Si installa prima R, poi RStudio. Entrambi sono gratuiti anche per uso professionale.
Vedi anche
Python · SQL e DuckDB · Quarto · Git