Prima di calcolare una media o lanciare un test, conviene guardare come si distribuiscono i dati. Quanti pazienti hanno una degenza di un giorno, quanti di due, quanti oltre i trenta? La distribuzione di frequenza risponde a questa domanda. È il primo strumento dell'analisi, e spesso quello che fa scoprire di più.
Che cos'è, in parole semplici
Una distribuzione di frequenza è un conteggio ordinato: per ogni valore, o per ogni gruppo di valori, si conta quante volte compare. È ciò che si fa istintivamente quando si mette in fila una pila di cartelle cliniche per durata del ricovero. Il risultato si mostra in una tabella o in un grafico, e restituisce in un colpo d'occhio la "forma" dei dati: dove si concentrano, quanto si allargano, se ci sono valori strani.
Assolute, relative, cumulate
La frequenza assoluta è il conteggio: 120 ricoveri con degenza di tre giorni. La frequenza relativa è la quota sul totale ed è quella che permette di confrontare gruppi di dimensioni diverse, come due ospedali con volumi molto differenti. La frequenza cumulata dice quanti casi stanno sotto una certa soglia: "il 75% dei ricoveri dura al massimo sei giorni".
Tabelle e grafici
Per le variabili categoriche si usano tabelle e diagrammi a barre. Per le variabili continue si raggruppano i valori in classi e si usa l'istogramma, in cui l'area di ogni barra è proporzionale al numero di casi. Per confrontare più gruppi sono utili i box plot e le curve di densità sovrapposte.
Gli errori più comuni
La scelta delle classi cambia l'aspetto di un istogramma: classi troppo larghe nascondono la struttura, classi troppo strette mostrano solo rumore. Vale la pena provare più ampiezze prima di scegliere. Un altro errore frequente è confrontare frequenze assolute tra gruppi di dimensioni diverse. Infine, le classi aperte ("oltre 30 giorni") vanno dichiarate, perché possono nascondere valori estremi importanti.
Cosa si scopre guardando
Una distribuzione mostra cose che nessun indice riassuntivo rivela: due picchi, segno che nel dato convivono due popolazioni diverse; valori impossibili, come età negative o degenze di migliaia di giorni; accumuli sospetti su certi valori, come le date al primo del mese o i pesi arrotondati alla decina.
Un esempio in sanità
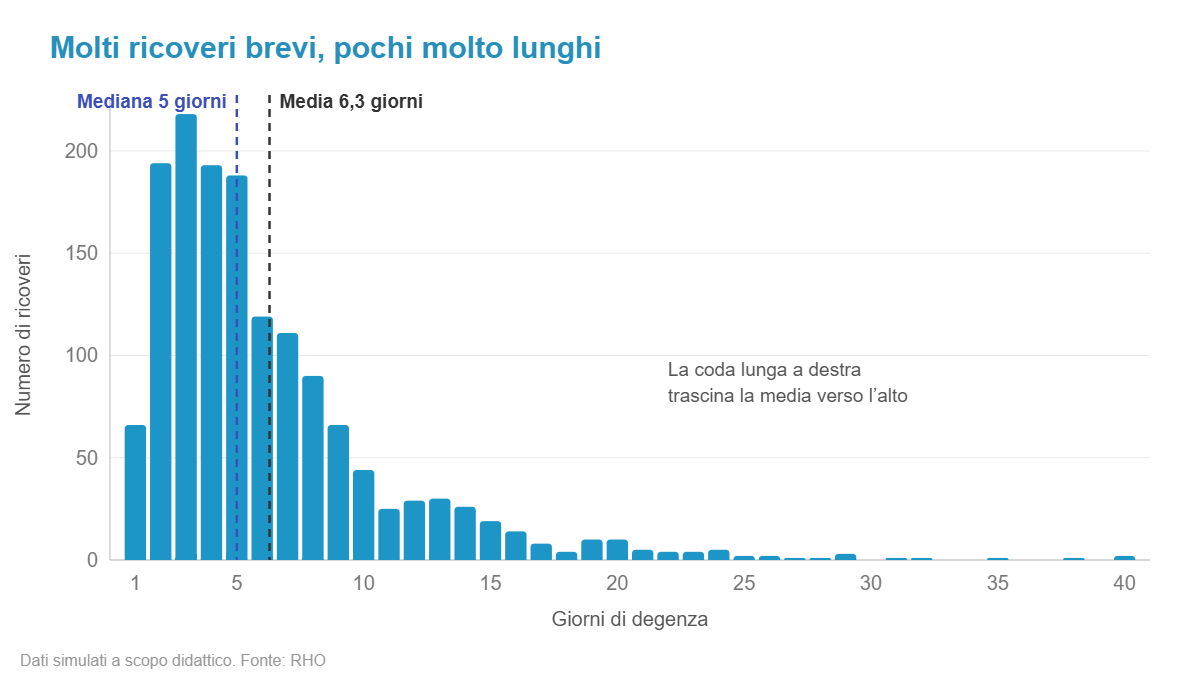
La distribuzione della degenza in un reparto di medicina ha tipicamente una lunga coda a destra: molti ricoveri brevi e pochi molto lunghi. Guardarla prima di tutto suggerisce subito che la media non sarà l'indice più adatto a descriverla, e che i ricoveri molto lunghi meritano un'analisi a parte.
Le definizioni formali
Su \(n\) osservazioni raggruppate in \(k\) classi, con \(n_j\) osservazioni nella classe \(j\):
$$f_j = \frac{n_j}{n}, \qquad F_j = \sum_{i \le j} f_i, \qquad \sum_{j=1}^{k} f_j = 1$$dove \(f_j\) è la frequenza relativa e \(F_j\) quella cumulata. La funzione di ripartizione empirica generalizza \(F_j\) a ogni valore \(x\):
$$\hat F_n(x) = \frac{1}{n}\sum_{i=1}^{n} \mathbf{1}(x_i \le x)$$È la base di molti metodi: i quantili empirici ne sono l'inversa, e il test di Kolmogorov-Smirnov misura la distanza massima tra due funzioni di ripartizione.
L'istogramma come stima di una densità
In un istogramma con classi di ampiezza \(h\), l'altezza della barra che contiene \(x\) è
$$\hat f(x) = \frac{n_j}{n\,h}$$così che l'area totale sia 1. Con classi di ampiezza diversa è l'area, e non l'altezza, a dover essere proporzionale alla frequenza: disegnare barre di altezza \(n_j\) con larghezze diverse è un errore frequente.
Quante classi?
La regola di Sturges suggerisce \(k = \lceil \log_2 n \rceil + 1\) classi ed è pensata per dati quasi normali: con distribuzioni asimmetriche e campioni grandi tende a usarne troppo poche. La regola di Freedman-Diaconis fissa invece l'ampiezza in base allo scarto interquartile, ed è più robusta:
$$h = 2\,\frac{\mathrm{IQR}}{n^{1/3}}$$Un'alternativa senza classi è la stima di densità a nucleo (kernel density), che sostituisce le barre con una curva continua; anche lì va scelta, e dichiarata, l'ampiezza di banda.
Tabelle e istogrammi in R
set.seed(11)
degenza <- pmax(1, round(exp(rnorm(1500, 1.6, 0.7))))

# Frequenze assolute, relative e cumulate
tab <- table(cut(degenza, breaks = c(0, 3, 7, 14, 30, Inf),
                 labels = c("1-3", "4-7", "8-14", "15-30", ">30")))
cbind(assolute = tab,
      relative = round(prop.table(tab), 3),
      cumulate = round(cumsum(prop.table(tab)), 3))

# Istogramma con la regola di Freedman-Diaconis
hist(degenza[degenza <= 40], breaks = "FD", col = "#1D95C6",
     border = "white", xlab = "Giorni di degenza", main = "")

# Numero di classi suggerito dalle due regole
nclass.Sturges(degenza)
nclass.FD(degenza)
Come leggere l'output
Sui 1.500 ricoveri simulati, il 30,1% dura da 1 a 3 giorni e il 42,6% da 4 a 7: in totale il 72,7% dei ricoveri non supera la settimana. Solo lo 0,6% supera i 30 giorni.
Le due regole danno indicazioni molto diverse: Sturges suggerisce 12 classi, Freedman-Diaconis 75. Con una distribuzione così asimmetrica e 1.500 osservazioni, 12 classi schiacciano la parte iniziale, dove si concentra quasi tutto. Il consiglio pratico è provarne più d'una e scegliere quella che mostra la struttura senza rumore.